


Kafka のデータをPythonのpetlでETL処理する方法|CData Connect AI
CData Connect AI の Python SDK と petl フレームワークを使うと、Kafka のデータをローカルにドライバーをインストールすることなく、Pythonで直接抽出・変換・ロードするETLパイプラインを構築できます。パーソナルアクセストークンで接続し、数行のコードで設定完了です。
Python は豊富なモジュールのエコシステムを備えているため、素早く作業に取りかかり、システムをより効果的に連携できます。CData Connect AI Python SDK と petl フレームワークを使えば、Kafka のデータを抽出・変換して CSV などに出力する Kafka 連携のアプリケーションやパイプラインを構築できます。この記事では、Connect AI に接続し、petl を使ってKafka のデータを抽出・変換し、CSV ファイルに書き出す方法をご紹介します。
Connect AI Python SDK(cdata-connect-ai)は DB-API 2.0(PEP 249)に準拠したクライアントなので、petl は etl.fromdb を使って SDK の接続から直接読み取れます。ソースごとにドライバーをインストールする必要はありません。パーソナルアクセストークンで接続して、パイプラインを構築しましょう。
Python + petl でできること
Kafka データの定期抽出パイプライン構築
SQL クエリで取得した Kafka のレコードを petl の etl.fromdb で抽出し、etl.sort などの変換処理をはさんでから CSV に書き出す、軽量な ETL パイプラインを構築できます。
複数データソースとの統合分析
DB-API 2.0 準拠のクライアントなので、同じコードパターンで Kafka 以外のデータソースにも接続でき、petl 上で結合・整形してから任意の出力先にロードできます。
Kafka への書き戻し処理の自動化
書き込みに対応した権限を持つ PAT で接続していれば、cursor.executemany を使ったバッチ INSERT により、変換済みデータを Kafka に自動で書き戻す処理を組み込めます。
Connect AI で Kafka に接続する方法は?
CData Connect AI では、直感的なクリック操作ベースのインターフェースでデータソースに接続できます。
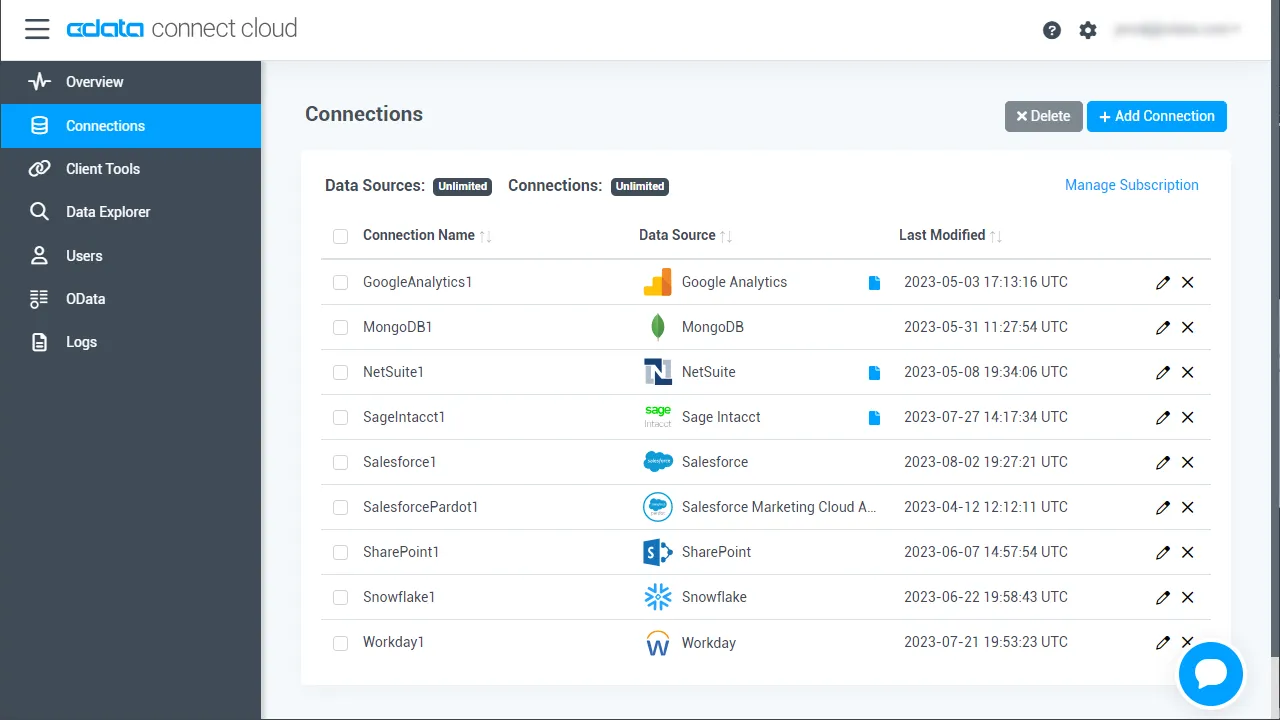
- Connect AI にログインし、Sources をクリックして、 Add Connection をクリックします
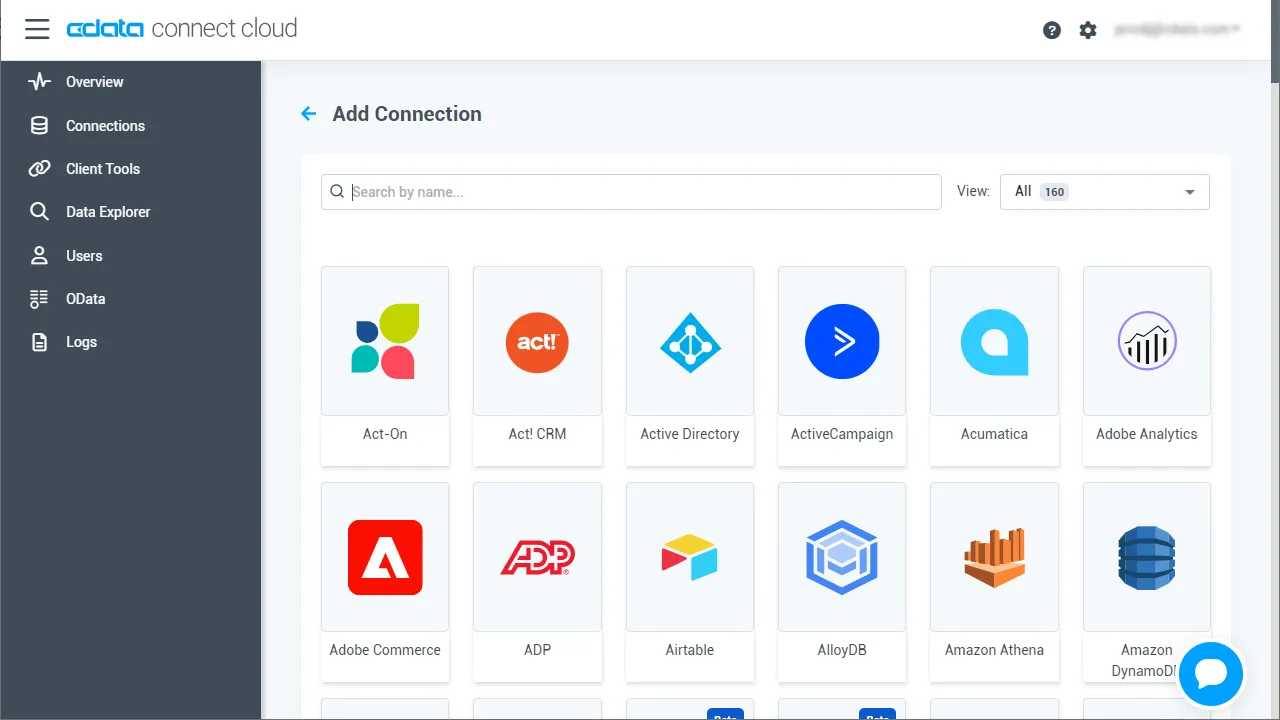
- 「Add Connection」パネルから「Kafka」を選択します
-
Kafka に接続するために必要な認証プロパティを入力します。
Apache Kafka 接続プロパティの取得・設定方法
それでは、Apache Kafka に接続していきましょう。.NET ベースのエディションは、Confluent.Kafka およびlibrdkafka ライブラリに依存して機能します。 これらのアセンブリはインストーラーにバンドルされており、CData 製品と一緒に自動的にインストールされます。 別のインストール方法をご利用の場合は、NuGet から依存関係のあるConfluent.Kafka 2.6.0をインストールしてください。
Apache Kafka サーバーのアドレスを指定するには、BootstrapServers パラメータを使用します。
デフォルトでは、CData 製品はデータソースとPLAINTEXT で通信しており、そのため、データはすべて暗号化されずに送信されます。 通信を暗号化したい場合は、以下の設定を行ってください:
- UseSSL をtrue に設定し、CData 製品がSSL 暗号化を使用するように構成します
- SSLServerCert およびSSLServerCertType を設定して、サーバー証明書をロードします
Apache Kafka への認証
続いて、認証方法を設定しましょう。Apache Kafka データソースでは、以下の認証方法をサポートしています:
- Anonymous
- Plain
- SCRAM ログインモジュール
- SSL クライアント証明書
- Kerberos
Anonymous 認証
Apache Kafka の特定のオンプレミスデプロイメントでは、認証接続プロパティを設定することなくApache Kafka に接続できます。 このような接続はanonymous(匿名)と呼ばれます。
匿名認証を行うには、以下のプロパティを設定してください。
- AuthScheme:None
その他の認証方法については、ヘルプドキュメントをご確認ください。
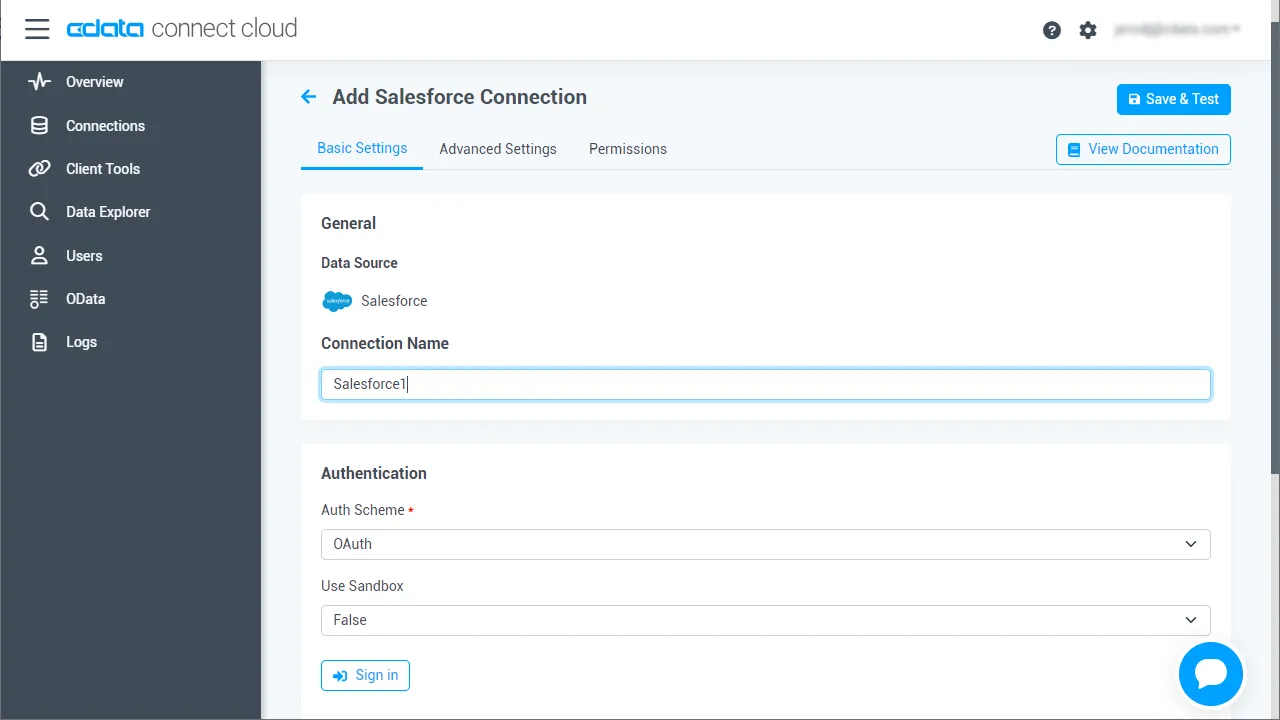
- 「Save & Test」をクリックします
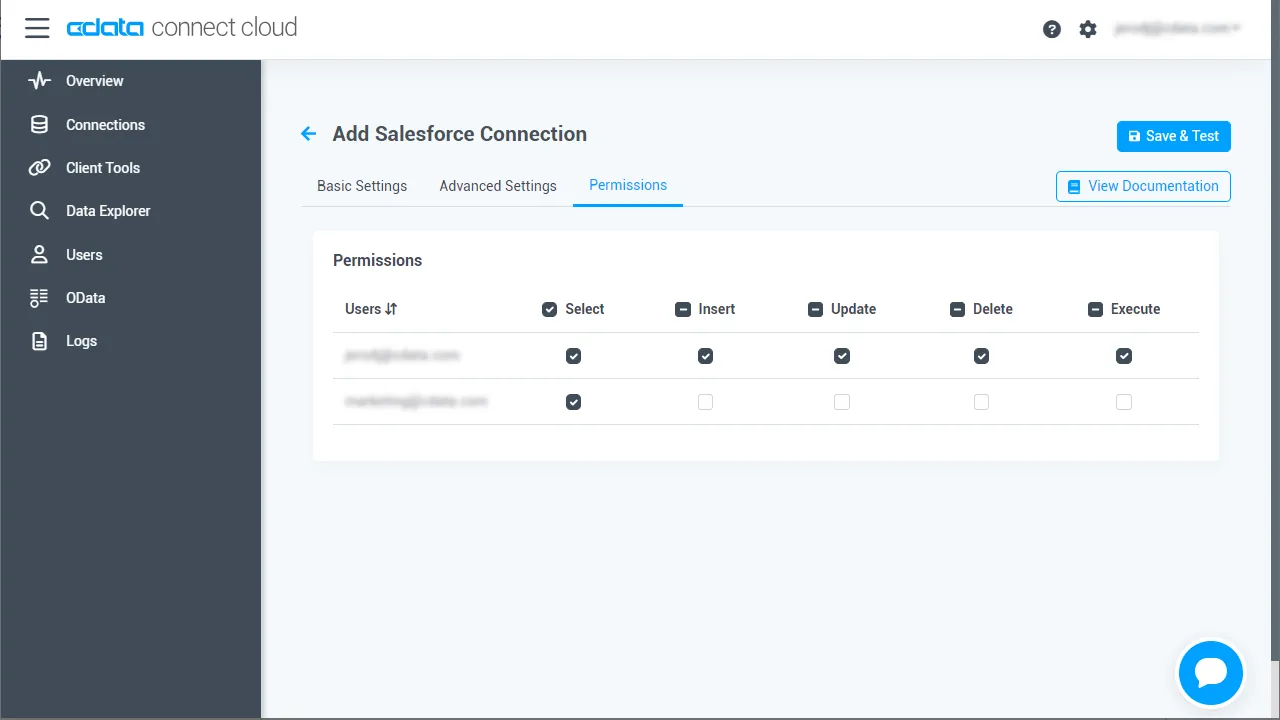
- 「Permissions」タブに移動し、ユーザーベースの権限を更新します。
パーソナルアクセストークン(PAT)を生成する
Python SDK は、アカウントのメールアドレスとパーソナルアクセストークン(PAT)を使って Connect AI に認証します。アクセスの粒度を保つために、アプリケーションごとに個別の PAT を作成することをおすすめします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして、設定ページを開きます。
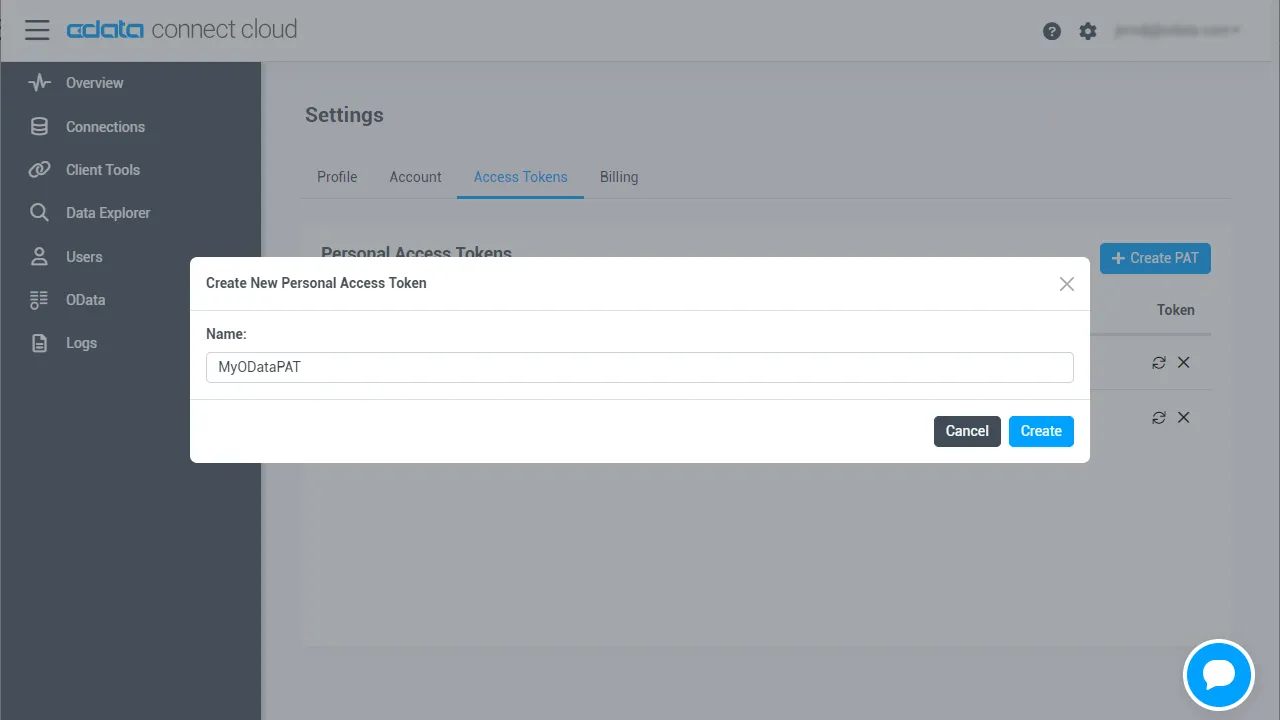
- 設定ページの Access Tokens セクションに移動し、 Create PAT をクリックします。
- PAT に名前を付けて Create をクリックします。
- パーソナルアクセストークンは作成時にのみ表示されます。必ずコピーして安全な場所に保管してください。
必要なモジュールをインストールする方法は?
pip ユーティリティを使って、SDK と petl フレームワークをインストールします。
pip install cdata-connect-ai
pip install petl
Python で Kafka のデータの ETL アプリを構築する方法は?
必要なモジュールをインストールしたら、ETL アプリを構築する準備は完了です。以下にコードスニペットを紹介しますが、完全なソースコードは記事の末尾に掲載しています。
まずモジュールをインポートし、アカウントのメールアドレスと PAT で Connect AI に接続します。
import petl as etl
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)
Kafka をクエリする SQL ステートメントを作成する方法は?
SQL を使って、Kafka をクエリするステートメントを作成します。この記事では、SampleTable_1 エンティティからデータを読み取ります。識別子は <Connection>.<Schema>.<Table> という3つの部分で構成されており、接続名はデフォルトでソース名(例:ApacheKafka1)になります。
sql = (
    "SELECT Id, Column1 "
    "FROM [ApacheKafka1].[ApacheKafka].[SampleTable_1] "
    "WHERE Column2 = '100'"
)
Kafka のデータの抽出・変換・ロードを実装する方法は?
接続とクエリが準備できたら、petl を使ってKafka のデータを抽出・変換・ロードします。この例では、Kafka のデータを抽出し、Column1 カラムでデータを並べ替えて、CSV ファイルにロードします。
table1 = etl.fromdb(conn, sql)

table2 = etl.sort(table1, 'Column1')

etl.tocsv(table2, 'sampletable_1_data.csv')
新しい行を Kafka に書き戻す方法は?
Kafka が書き込みに対応している場合は、バッチ INSERT で行を書き戻せます。SDK の executemany は、@name のプレースホルダーと、1行につき1つのパラメータ辞書のリストを受け取ります。
cur = conn.cursor()
cur.executemany(
    "INSERT INTO [ApacheKafka1].[ApacheKafka].[SampleTable_1] (Id, Column1) "
    "VALUES (@val1, @val2)",
    [
        {"@val1": "New value 1", "@val2": "New value 1"},
        {"@val1": "New value 2", "@val2": "New value 2"},
    ],
)
print(f"Rows inserted: {cur.rowcount}")

conn.close()
注意:書き込み可能なソースであっても、読み取り専用の PAT や接続権限では書き込み操作は拒否されます。
CData Connect AI Python SDK を使えば、petl のような ETL パッケージでのデータへの直接アクセスも含め、通常のデータベースと同じようにKafka のデータを扱えます。
関連情報と無料トライアル
これで、CData Connect AI Python SDK を使って、petl でリアルタイムのKafka のデータをパイプライン処理できるようになりました。Kafka(および数百種類のその他のデータソース)への接続について詳しくは、Connect AI のページをご覧ください。
CData Connect AI の詳細、または無料トライアルにお申し込みください:
完全なソースコード
import petl as etl
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)

sql = (
    "SELECT Id, Column1 "
    "FROM [ApacheKafka1].[ApacheKafka].[SampleTable_1] "
    "WHERE Column2 = '100'"
)

table1 = etl.fromdb(conn, sql)

table2 = etl.sort(table1, 'Column1')

etl.tocsv(table2, 'sampletable_1_data.csv')

cur = conn.cursor()
cur.executemany(
    "INSERT INTO [ApacheKafka1].[ApacheKafka].[SampleTable_1] (Id, Column1) "
    "VALUES (@val1, @val2)",
    [
        {"@val1": "New value 1", "@val2": "New value 1"},
        {"@val1": "New value 2", "@val2": "New value 2"},
    ],
)
print(f"Rows inserted: {cur.rowcount}")
conn.close()