


【MCP Server】LlamaIndex からBitbucket のデータに連携しよう!
LlamaIndex は、LLM アプリケーションを構築するためのデータフレームワークです。エージェントや RAG パイプライン、外部データをもとに推論する構造化ワークフローなどを開発できます。LlamaIndex と CData Connect AI を組み込みの MCP Server を通じて統合すれば、カスタムコネクタを書くことなく、エージェントがライブの Bitbucket のデータ をネイティブツールとして検出・クエリできるようになります。
CData Connect AI は、Bitbucket をはじめとするさまざまなデータソースに接続できる、セキュアでローコードな環境を提供します。複雑な ETL を必要とせず、リアルタイムデータを使ったビジネスアプリケーション間のシームレスな自動化を実現します。
この記事では、CData Connect AI での Bitbucket 接続の設定、LlamaIndex への MCP サーバーの登録、そして Bitbucket のデータ をリアルタイムでクエリする ReAct エージェントの構築方法をご紹介します。
前提条件
- CData Connect AI のアカウント
- Python バージョン 3.10 以上(LlamaIndex パッケージをインストールするため)
- OpenAI API キーを生成して保存
- システムに Visual Studio Code をインストール
ステップ 1:LlamaIndex 用の Bitbucket 接続を設定する
それでは早速、LlamaIndex から Bitbucket にアクセスできるようにしていきましょう。まず、CData Connect AI で Bitbucket 接続を作成します。この接続は、その後リモート MCP サーバーを通じて LlamaIndex に公開されます。
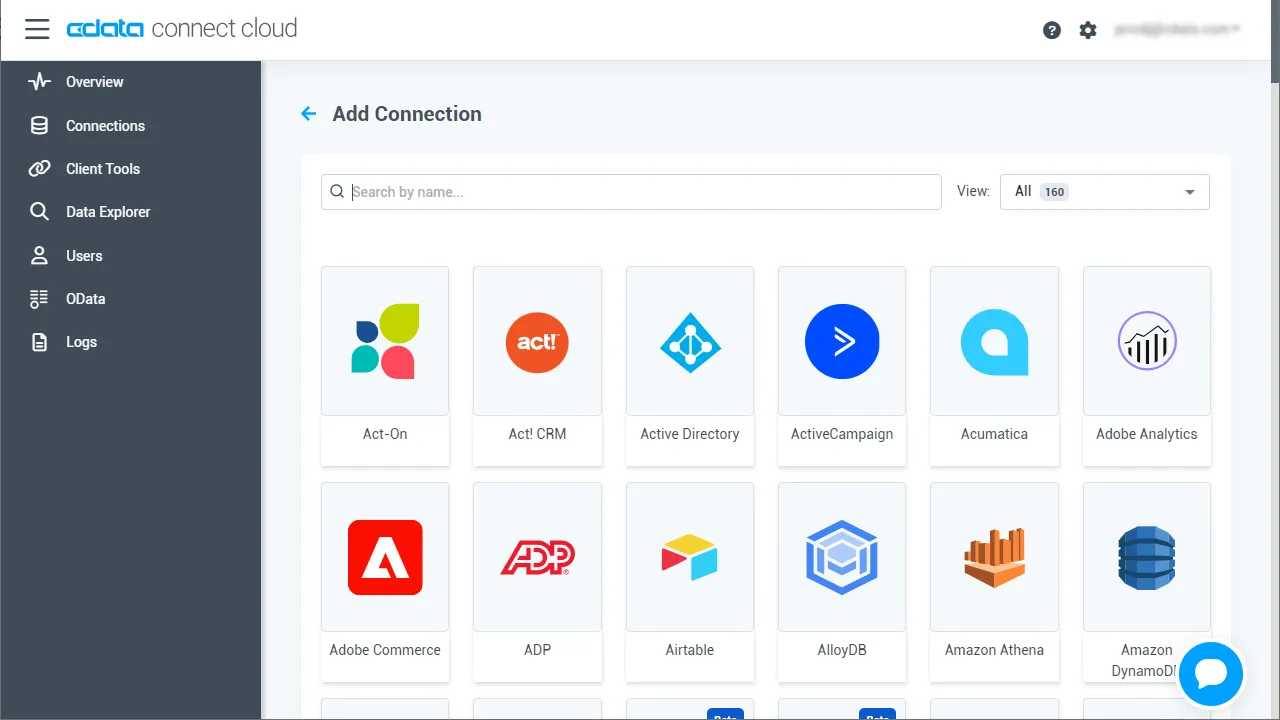
- Connect AI にログインし、「Sources」をクリックして「+ Add Connection」をクリックします
- 利用可能なデータソースから「Bitbucket」を選択します
-
Bitbucket に接続するために必要な認証情報を入力しましょう。
ほとんどのクエリでは、ワークスペースを設定する必要があります。唯一の例外は、Workspacesテーブルです。このテーブルはこのプロパティの設定を必要とせず、クエリを実行すると、Workspaceの設定に使用できるワークスペーススラッグのリストが提供されます。このテーブルにクエリを実行するには、スキーマを'Information'に設定し、SELECT * FROM Workspacesクエリを実行する必要があります。
Schemaを'Information'に設定すると、一般的な情報が表示されます。Bitbucketに接続するには、以下のパラメータを設定してください。
- Schema: ワークスペースのユーザー、リポジトリ、プロジェクトなどの一般的な情報を表示するには、これを'Information'に設定します。それ以外の場合は、クエリを実行するリポジトリまたはプロジェクトのスキーマに設定します。利用可能なスキーマの完全なセットを取得するには、sys_schemasテーブルにクエリを実行してください。
- Workspace: Workspacesテーブルにクエリを実行する場合を除き、必須です。Workspacesテーブルへのクエリにはこのプロパティは必要ありません。そのクエリはWorkspaceの設定に使用できるワークスペーススラッグのリストのみを返すためです。
Bitbucketでの認証
BitbucketはOAuth認証のみをサポートしています。すべてのOAuthフローからこの認証を有効にするには、カスタムOAuthアプリケーションを作成し、AuthSchemeをOAuthに設定する必要があります。
特定の認証ニーズ(デスクトップアプリケーション、Webアプリケーション、ヘッドレスマシン)に必要な接続プロパティについては、ヘルプドキュメントを必ず確認してください。
カスタムOAuthアプリケーションの作成
Bitbucketアカウントから、以下のステップを実行します。
- 設定(歯車アイコン)に移動し、ワークスペース設定を選択します。
- アプリと機能セクションで、OAuthコンシューマーを選択します。
- コンシューマーを追加をクリックします。
- カスタムアプリケーションの名前と説明を入力します。
- コールバックURLを設定します。
- デスクトップアプリケーションとヘッドレスマシンの場合、http://localhost:33333または任意のポート番号を使用します。ここで設定するURIがCallbackURLプロパティになります。
- Webアプリケーションの場合、信頼できるリダイレクトURLにコールバックURLを設定します。このURLは、ユーザーがアプリケーションにアクセスが許可されたことを確認するトークンを持って戻るWebの場所です。
- クライアント認証情報を使用して認証する予定の場合、これはプライベートコンシューマーですを選択する必要があります。ドライバーでは、AuthSchemeをclientに設定する必要があります。
- OAuthアプリケーションに与える権限を選択します。これにより、読み取りおよび書き込みできるデータが決まります。
- 新しいカスタムアプリケーションを保存するには、保存をクリックします。
- アプリケーションが保存された後、それを選択して設定を表示できます。アプリケーションのKeyとSecretが表示されます。これらを将来の使用のために記録してください。Keyを使用してOAuthClientIdを設定し、Secretを使用してOAuthClientSecretを設定します。
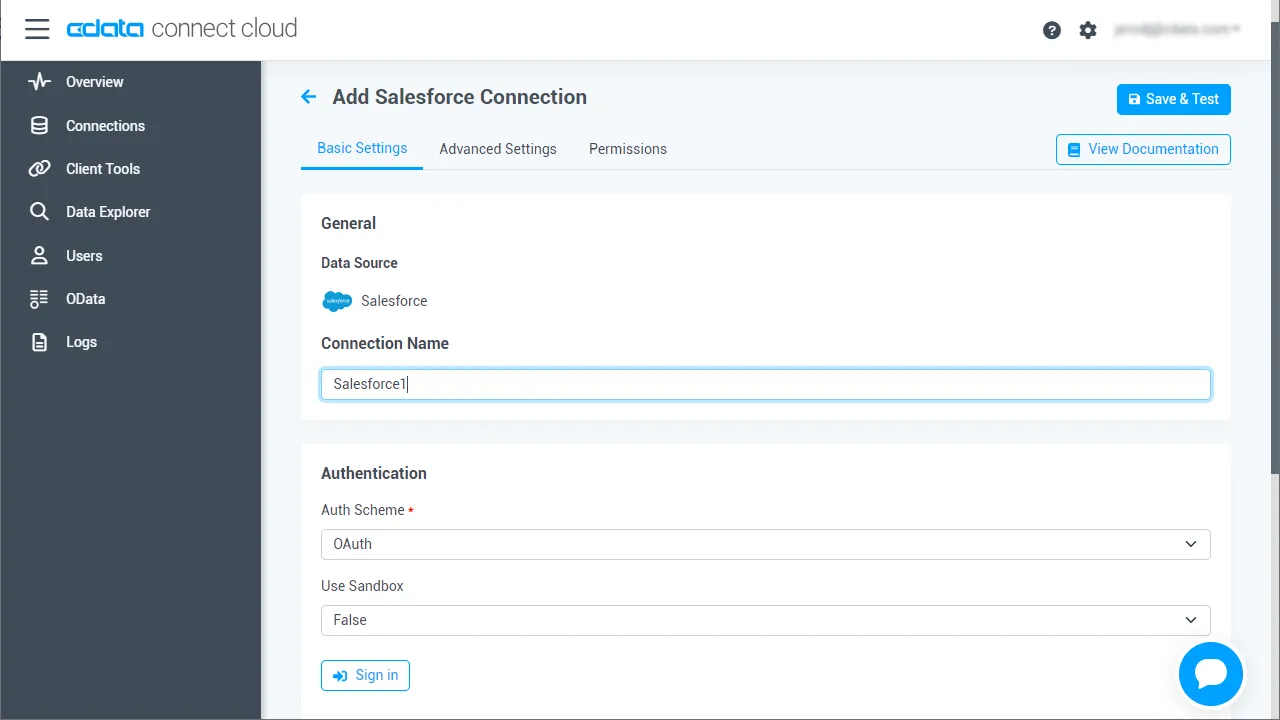
- 「Save & Test」をクリックします
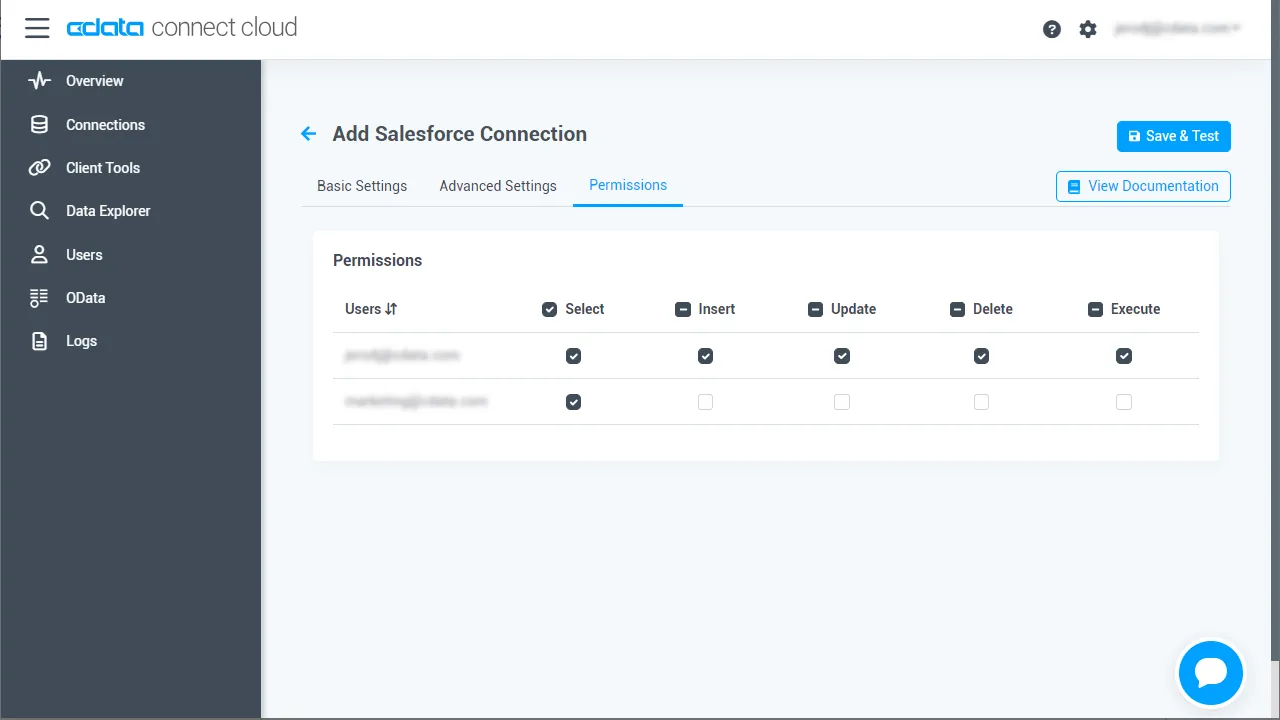
- 認証が完了したら、Bitbucket 接続の「Permissions」タブを開き、必要に応じてユーザーベースの権限を設定します
パーソナルアクセストークン(PAT)を生成する
LlamaIndex は、アカウントのメールアドレスとパーソナルアクセストークン(PAT)を使用して Connect AI に認証します。アクセス制御の粒度を維持するために、統合ごとに個別の PAT を作成することをおすすめします。
- Connect AI で、右上の歯車アイコンを選択して「Settings」を開きます
- 「Access Tokens」で、「Create PAT」を選択します
- トークンのわかりやすい名前を付けて、「Create」を選択します
- トークンをコピーして安全に保管してください。PAT は作成時にのみ表示されます
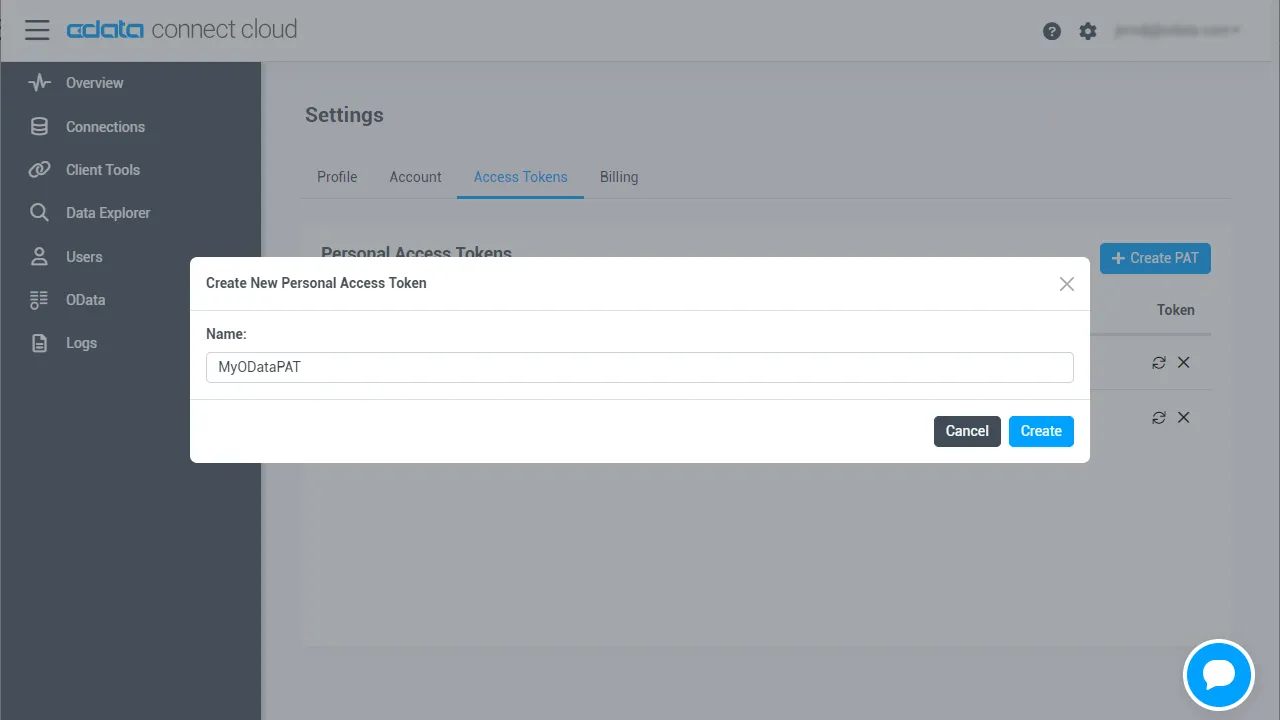
これで Bitbucket 接続の設定と PAT の生成が完了しました。LlamaIndex から CData MCP サーバーを通じて Bitbucket のデータ に接続する準備が整いました。
ステップ 2:LlamaIndex で MCP サーバーに接続する
続いて、LlamaIndex を CData Connect AI のリモート MCP サーバーに接続し、推論に OpenAI を使用していきましょう。MCP サーバーのエンドポイントと認証情報を
config.py- LlamaIndex MCP プロジェクト用のフォルダを作成します
- フォルダ内に
とconfig.py
の2つの Python ファイルを作成しますllamaindex_agent.py
で、MCP サーバーの URL と、Base64 エンコードされた CData Connect AI のメールアドレスおよび PAT(前提条件で取得したもの)を定義します。config.pyclass Config: MCP_BASE_URL = "https://mcp.cloud.cdata.com/mcp" # MCP Server の URL MCP_AUTH = "base64encoded(EMAIL:PAT)" # Base64 エンコードされた Connect AI の Email:PAT注:Base64 エンコードツールを使用して、MCP_AUTH の Base64 エンコード版を作成できます。
で、MCP ツールスペックと ReAct エージェントを設定します:llamaindex_agent.py""" LlamaIndex ReAct エージェントと CData Connect AI MCP サーバーを統合します。 このスクリプトは、MCP ツールを検出して LlamaIndex ツールとしてラップし、 OpenAI による推論で駆動されるエージェントループを実行します。 """ import asyncio from llama_index.tools.mcp import BasicMCPClient, McpToolSpec from llama_index.core.agent.workflow import ReActAgent from llama_index.llms.openai import OpenAI from config import Config async def main(): # Connect AI を指す MCP クライアントを初期化 mcp_client = BasicMCPClient( Config.MCP_BASE_URL, headers={"Authorization": f"Basic {Config.MCP_AUTH}"}, ) # MCP サーバーが公開するツール(getCatalogs、queryData など)を検出 tool_spec = McpToolSpec(client=mcp_client) tools = await tool_spec.to_tool_list_async() print("検出された MCP ツール:", [t.metadata.name for t in tools]) # ReAct ループを駆動する LLM を設定 llm = OpenAI( model="gpt-4o", temperature=0.2, api_key="YOUR_OPENAI_API_KEY", # https://platform.openai.com/ ) # MCP ツールを使用するエージェントを構築 agent = ReActAgent(tools=tools, llm=llm) user_prompt = "[rootadoname]1 で利用可能なテーブルはいくつありますか?" # 必要に応じて変更してください print(f" ユーザープロンプト: {user_prompt}") response = await agent.run(user_prompt) print("エージェントの最終応答:", response) if __name__ == "__main__": asyncio.run(main())
ステップ 3:LlamaIndex パッケージをインストールする
このワークフローでは LlamaIndex を CData Connect AI MCP サーバーおよび推論用の OpenAI と組み合わせて使用するため、必要な Python パッケージをインストールしていきましょう。
プロジェクトのターミナルで次のコマンドを実行してください。
pip install llama-index llama-index-tools-mcp llama-index-llms-openai
ステップ 4:LlamaIndex を使用して Bitbucket にプロンプトを送信する(MCP サーバー経由)
- インストールが完了したら、
を実行してスクリプトを実行しますpython llamaindex_agent.py - スクリプトは MCP サーバーに接続し、接続されたデータをクエリするために利用可能な CData Connect AI MCP ツールを検出します
- プロンプトを入力します(例:「Bitbucket で利用可能なテーブルはいくつありますか?」)
- エージェントは利用可能なツールをもとに推論し、Bitbucket に対して
を呼び出して、その結果を返しますqueryData
CData Connect AI でビジネスシステムのデータ活用を今すぐスタート
いかがでしたか?LlamaIndex から Bitbucket へのデータ接続が簡単に完了したのではないでしょうか。業務に使えそう、と感じてくださった方は、14 日間の無償トライアルで AI ツールからビジネスシステムへのリアルタイムデータ接続をぜひお試しください。