翻訳者ノート
こんにちは!コンテンツチームの加藤です。
AIエージェントの導入企画は進むのに、セキュリティ審査で止まってしまう——AIプロジェクトで頻出の課題ではないでしょうか。本記事では、エージェントのID設定や最小権限の原則など、AIガバナンスに欠かせないポイントを4本の柱にまとめています。情シス担当者の方が、稟議・審査をどう通すかの参考になれば幸いです。 |
 AIエージェントのデータガバナンスとは、エージェントがどの業務データにアクセスできるか、そのデータで何をしてよいか、そしてその行動をどう監視し誰の責任として記録するかを定める一連のポリシーのことです。この定義は、セキュリティ審査で必ず出てくる問いに直結します。つまりこのエージェントがSalesforceやSAPに問い合わせるとき、それは誰の権限で実行されているのか、そして後からそれを証明できるのか、という問いです。
従来型のガバナンスは、データを読み取って最後に人へ渡すシステムを前提に設計されてきました。エージェントはこの前提を崩します。エージェントはリクエストを推論し、ツールを呼び出し、時には人の確認を経ずに本番システムを変更できるからです。そのためガバナンスが統制すべき対象は、静的な読み取りアクセスだけでなく、実行時の自律的な行動そのものに広がります。
OWASPは2025年12月9日発行のTop 10 for Agentic Applicationsでこの点を明確にしています。チャットボットには存在しなかった失敗のパターン――ツールの誤用、IDや権限の乱用、誰も許可していない目的を追いかける暴走エージェント――が、エージェント型システムでは新たに生まれるのです。
こうした統制は、モデルがクエリを処理し出力を生成する推論(inference)の瞬間に効いていなければ意味がありません。ポリシー文書の中にだけ存在し、クエリが実際に通る経路の中には実装されていないガバナンスは、何も制御していないのと同じです。
NIST AI Risk Management Frameworkはこの作業を「ガバナンス(Govern)」・「マップ(Map)」・「測定(Measure)」・「管理(Manage)」という4つの機能で整理しており、本ガイドで扱う4本柱もこの構造に沿っています。CData Connect AIはこの定義を実装する一つの方法で、各チームが選んだエージェントを横断してアクセスとログ記録を強制する中立的なレイヤーです。ただしこの定義自体は、どのツールを選ぶかとは関係なく成り立ちます。
未整備なAIエージェントがコンプライアンス事故を生む理由
ガバナンスが整っていないエージェントは、企業が通常は別々に管理している3つのリスク領域――アプリケーションリスク、IDリスク、データリスク――を1つの運用モデルに一気に収束させます。過剰な権限を持つエージェントが1体いるだけでこのリスクが顕在化します。アクセスから実行、そして波及影響までを自動でつなぐ連鎖へとそのまま発展するからです。MicrosoftはOWASPのagenticリスクをCopilot Studioにマッピングした記事で、まさにこの収束を説明しています。
OWASP Top 10 for Agentic Applicationsは、多くのセキュリティチームが出発点にしているカタログです。その中でも「IDとアクセスの悪用」「無制限の自律性」という2つのカテゴリが、本番承認を止める最大の要因になっています。この慎重さには理由があります。シャドーAI・未承認のAIツールはIT部門が棚卸しできる速度を上回って広がり、かつてクラウドの設定ミスを警戒していたのと同じ審査がいまはモデル悪用やID侵害への耐性を当然のように求めているからです。以下の3つの失敗のパターンが最も頻繁に起き、それぞれ後述する統制に対応します。認証情報露出にはIDパススルー、監査ギャップにはクエリ単位の帰属ログ、スコープクリープにはワークスペース分離です。
MCPの導入によってどのようなリスクが新たに生まれ、IT部門としてどこから設計に着手すべきかは、AIエージェントとMCPのセキュリティリスク:IT部門が知っておくべき対策と設計ガイドで全体像を整理しています。
認証情報の露出
エージェントが共有のサービスアカウントで認証すると、すべてのクエリはそのアカウントが持つ権限の合算で実行され、実際のユーザーが本来持つ権限は不透明になります。過剰な権限を持っている認証情報(クレデンシャル)が1つでも漏えいすると、そのサービスアカウントがアクセスできる範囲すべてに到達できてしまいます。CDataで見てきた中でも、実ユーザーのIDの代わりに共有サービスアカウントを利用しているパターンがセキュリティ審査でPoCが止まってしまう原因で最多です。
監査ギャップ
クエリがエージェントに指示を出した個人に紐づけられていなければ、誰が何を見たのかを後から再構成できません。この差が、監査に耐えるログとお手上げ状態との違いを生むわけです。
スコープクリープ
スコープクリープとは、エージェントのデータアクセス範囲が、そのタスクに必要な範囲を超えてじわじわと広がっていく現象です。一つひとつの権限追加は無害に見えても、積み重なると誰も意図していなかったデータにまでエージェントが届いてしまい、最小権限の原則に反する状態になります。
前提条件:AIエージェント導入前にIT部門が用意すべきもの
よくある間違いは、まずデータソースをエージェントに接続してガバナンスはあとから整える、というやり方です。AIによる検索・取得はデータソース側の権限とデータ品質をそのまま引き継ぐため、ロールベースアクセス制御(RBAC)を含むガバナンスは、AIを接続する前にデータソース側で確立されていなければなりません。エージェントは人間のユーザーでも共有アカウントでもなく、スコープを絞った権限を持つ独立したIDとして扱う必要があります。この分野で広がりつつある標準がOAuth 2.1ベースの認可で、Model Context Protocol(MCP)のクライアントが保護されたリソースへ認可を通ってアクセスする仕組みです。
多くの企業では、この確認は1ステップでは完結せず情シス・法務・事業部門など複数階層の合議を経た稟議として進むケースが一般的です。データ所有者の指名やアクセスポリシーの承認もこの稟議プロセスの中で確定させておくと、後工程のセキュリティ審査がスムーズに進むでしょう。
前提条件 | 定義すべきこと | エージェント接続前に重要な理由 |
IDの基盤 | 中央IdP(Entra ID、Oktaなど)とOAuth/SAML | エージェントのクエリが、共有サービスアカウントではなくエンドユーザーのIDを引き継げるようになる |
データ所有者と分類 | データソースごとの名前付き所有者と機密度ラベル | どのエージェント・ロールがそのデータソースに到達してよいかを決める |
データの系統 | データの出所とその流れ | エージェントが返した内容を、出どころまでさかのぼって追跡できる |
アクセスポリシー | データソース側のRBACロールと行/列単位のスコープ | 取得はデータソース側の権限をそのまま引き継ぐため、先に正しくしておく必要がある |
保持ポリシー | エージェントがアクセスするデータとログの保持期間 | クエリが動く前に監査・コンプライアンスの境界を決めておく |
Connect AIはこれらの前提条件を単一のプラットフォーム上で満たせます。Salesforce・SAPだけでなくkintoneやExcelを含む数百のデータソースに対応し、個々のサービスに合わせて構成を作る必要はありません。
AIエージェント・ガバナンスの4本柱
ここからは、IT部門が実際に手を動かして統制できる項目を見ていきましょう。NISTの「ガバナンス(Govern)」・「マップ(Map)」・「測定(Measure)」・「管理(Manage)」という4機能に対応しており、安全なAIエージェント・ガバナンスのベストプラクティスの延長線上にあります。
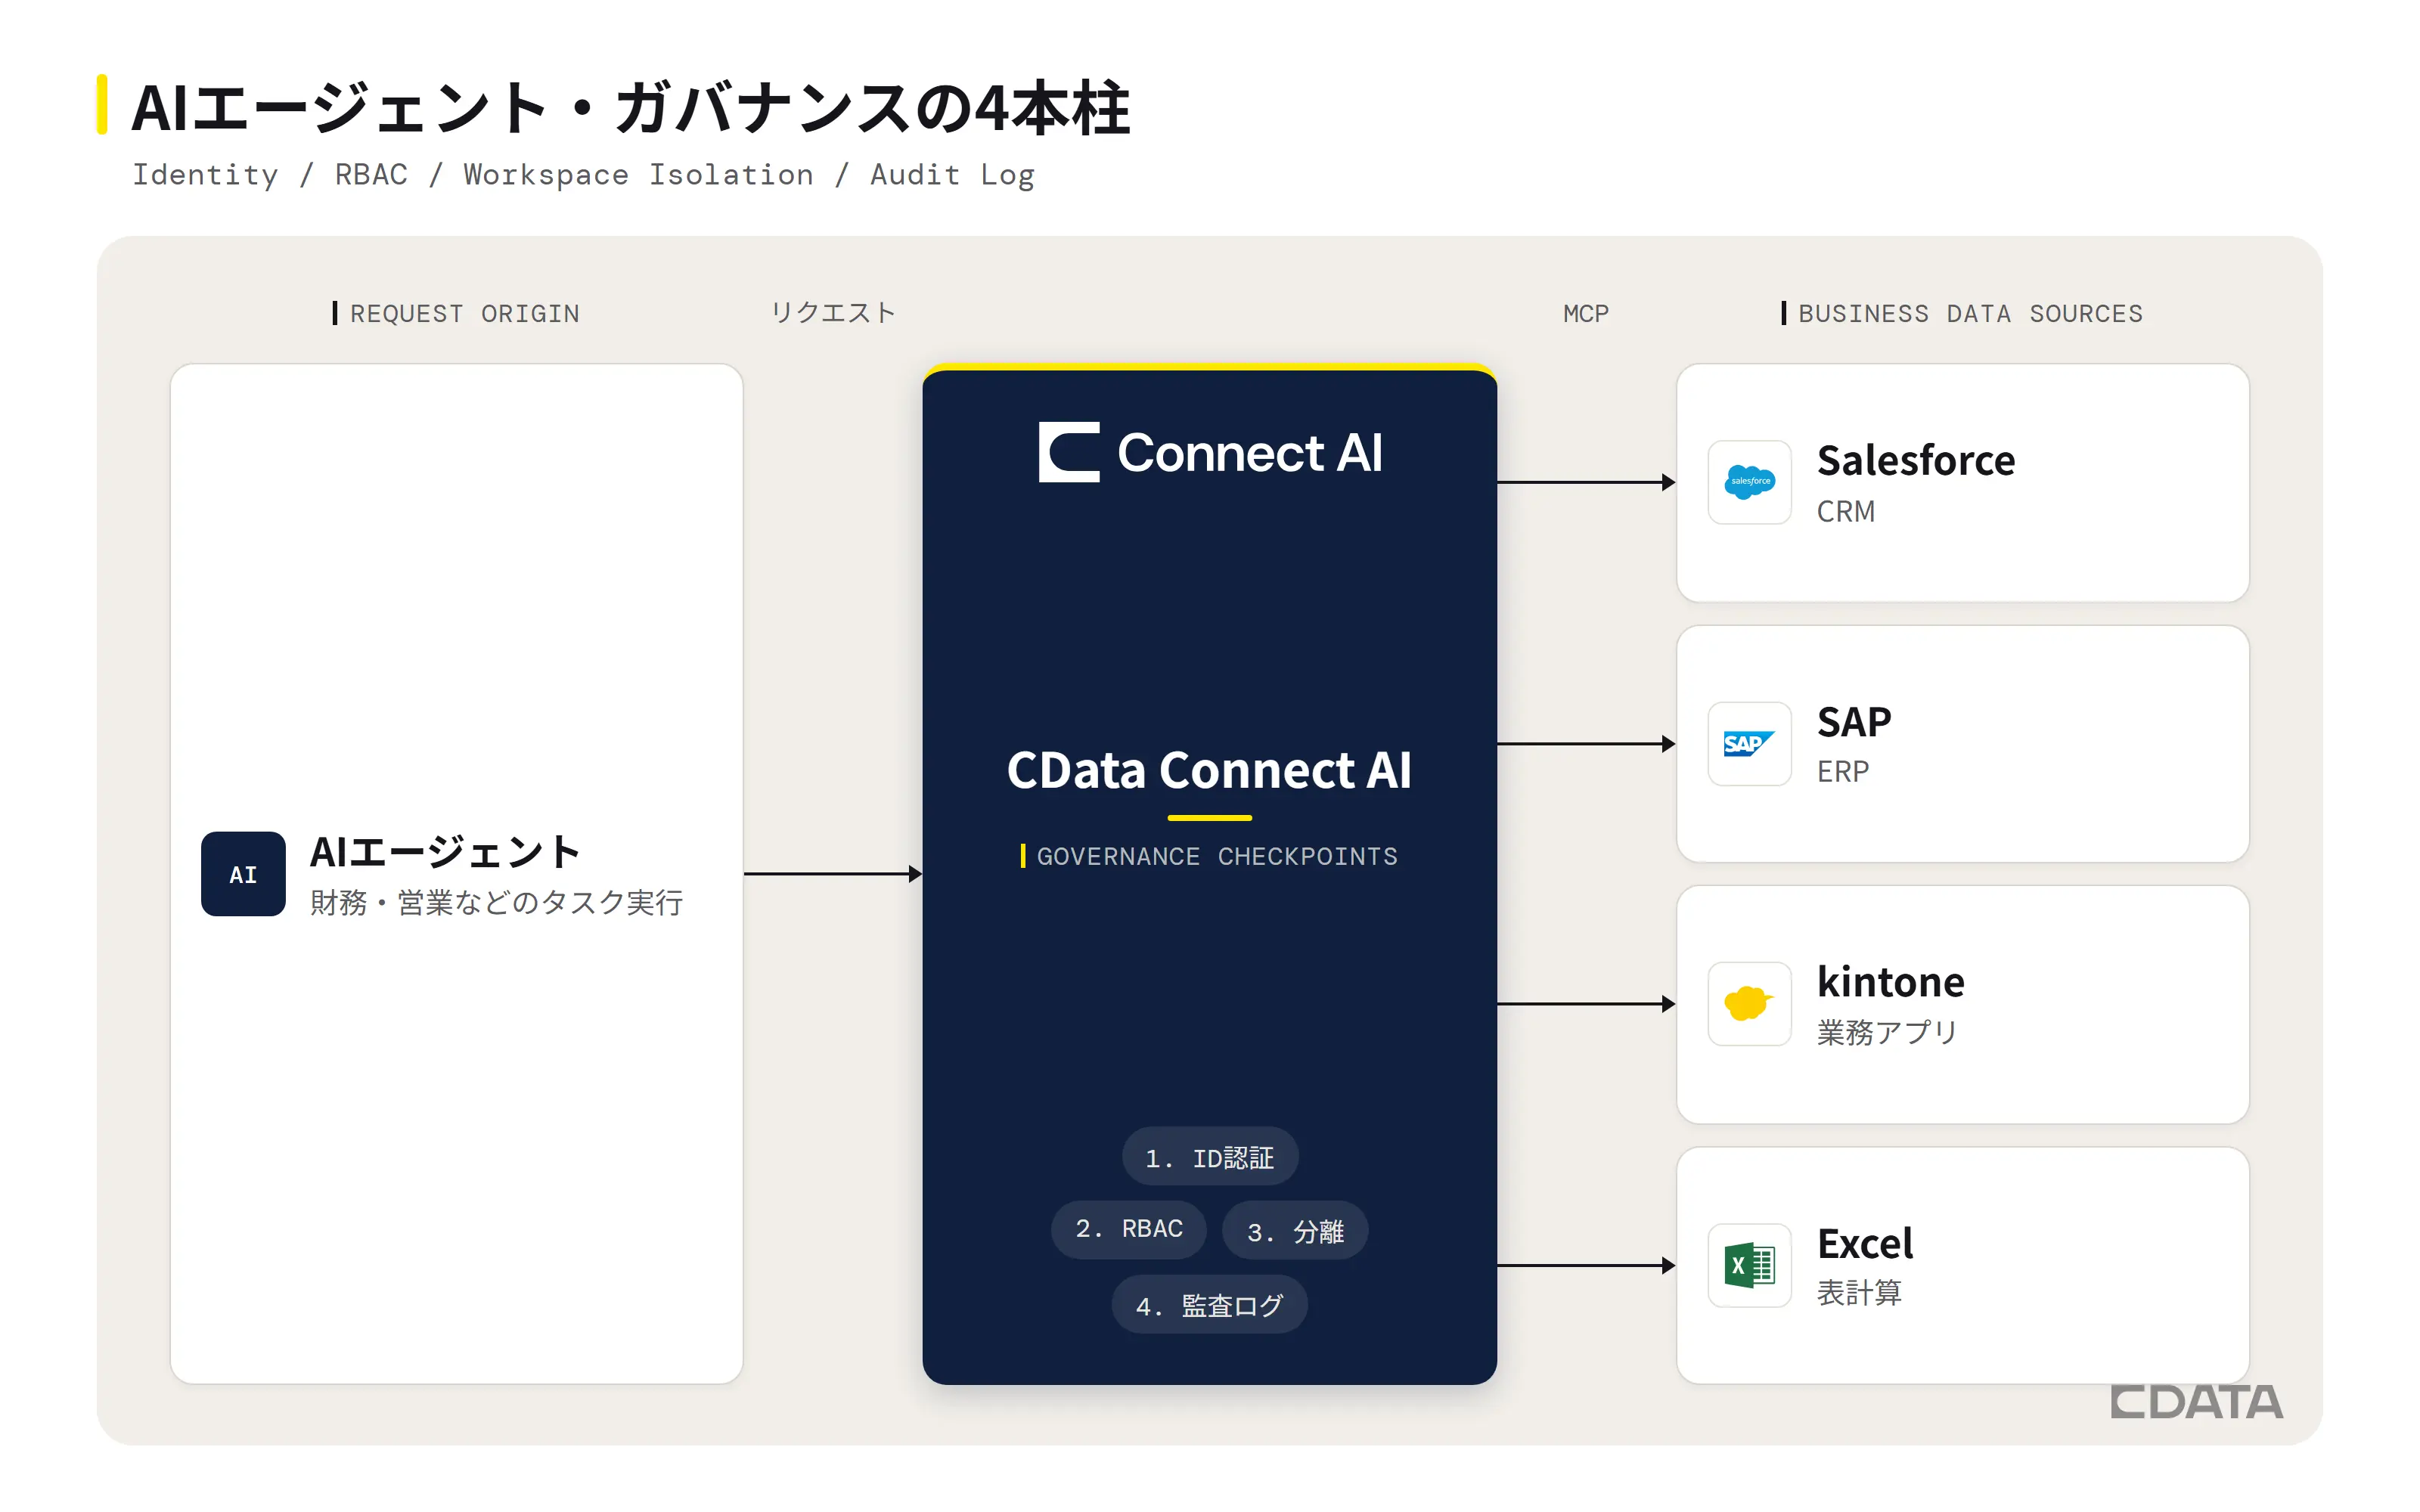
柱1:エージェントのIDと認証(OAuth/SAMLパススルー)
MCPの認可モデルはOAuth 2.1をベースに構築されています。MCPサーバーはリソースサーバーとして振る舞い、すべてのアクセストークンが自分自身のために発行されたものであることを、リソースインジケータを使ってオーディエンス単位で検証します。
実務上これが意味するのは、エージェントは共有キーではなくOAuthまたはSAML パススルーを通じて、エンドユーザーとして認証するということです。データソースに届くIDは、社内ディレクトリがすでに把握している実在の人物のIDになります。Microsoft FoundryのエージェントからSalesforceデータへOAuth identityパススルーを設定する具体的な手順は、Microsoft Foundry エージェントから Salesforce データに安全にアクセスする連携ガイドで確認できます。
柱2:RBACとパススルー権限の強制
RBACはNISTの定義では、許可されたアクションをリソースに対して定めるとき、個々のIDではなくロールに紐づける仕組みです。ユーザーが引き継げるのは、自分に割り当てられたロールの権限だけです。パススルーがあってはじめて、このRBACはエージェントにも成立します。
クエリはエンドユーザーのIDのもとで実行されるため、そのユーザーをすでに制御しているロール権限がそのままエージェントのリクエストにも適用されます。SalesforceやSAPだけでなく、kintoneやExcelのような日本企業で広く使われているデータソースでも、この仕組みは同じように機能しなければなりません。kintoneではユーザーごとの認証設定が別途必要になる場合があり、その具体的な手順はkintone MCP コネクタが Per User Authentication に対応した際の設定方法で解説しています。
柱3:ワークスペース分離と最小権限のスコープ設定
最小権限の原則は、ある機能に必要な最小限のアクセスだけを与えるという考え方で、ゼロトラストの実装を支える前提そのものです。ワークスペース分離は、これを構造として実装します。財務エージェントは財務系システムだけを見て、営業エージェントはCRMだけを見ます。対象となるデータソースがSalesforceやkintoneのようなCRM・業務データソースであっても、Excelで管理された台帳であっても、1つのエージェントが及ぼせる影響範囲は設計によって最初から区切られるべきです。
ID パススルーとワークスペース分離を組み合わせた具体的なアクセス制御の設計は、生成AIとエンタープライズデータを安全につなぐ5層アクセス制御モデルも参考になります。
柱4:監査証跡の設定とSIEMへの連携
監査に耐える記録には、データの経路全体を再構成できるだけの情報が必要です。具体的には、何がその行動を引き起こしたのか、エージェントがどのデータを使ったのか、何を実行したのか、その結果はどうだったのかを押さえておく必要があります。実行イベントとポリシー適用の判定は、セキュリティチームがすでに他のあらゆるものを監視しているセキュリティ情報イベント管理(SIEM)基盤に流し込むべきです。
柱 | 一文定義 | 主な統制 | 防止される失敗のパターン |
IDと認証 | エージェントは共有アカウントではなくエンドユーザーとして認証する | OAuth/SAMLパススルー | 認証情報の露出 |
RBACとpassthrough | クエリはエンドユーザーのロール権限のもとで実行される | データソースのRBACに対するIDパススルー | 過剰な権限 |
ワークスペース分離 | 各エージェントはタスクに必要なシステムだけに届く | ワークスペース単位の最小権限スコープ | スコープクリープ |
監査証跡とSIEM連携 | すべての行動が個人に帰属し、再構成できる | クエリ単位のログを企業の監視基盤へ | 監査ギャップ |
PoCから本番へ、AIエージェントの展開手順
ガバナンスの必須項目を見たところで、アクセスのスコープを決めるところから本番稼働前の検証までを具体的な手順として追っていきましょう。
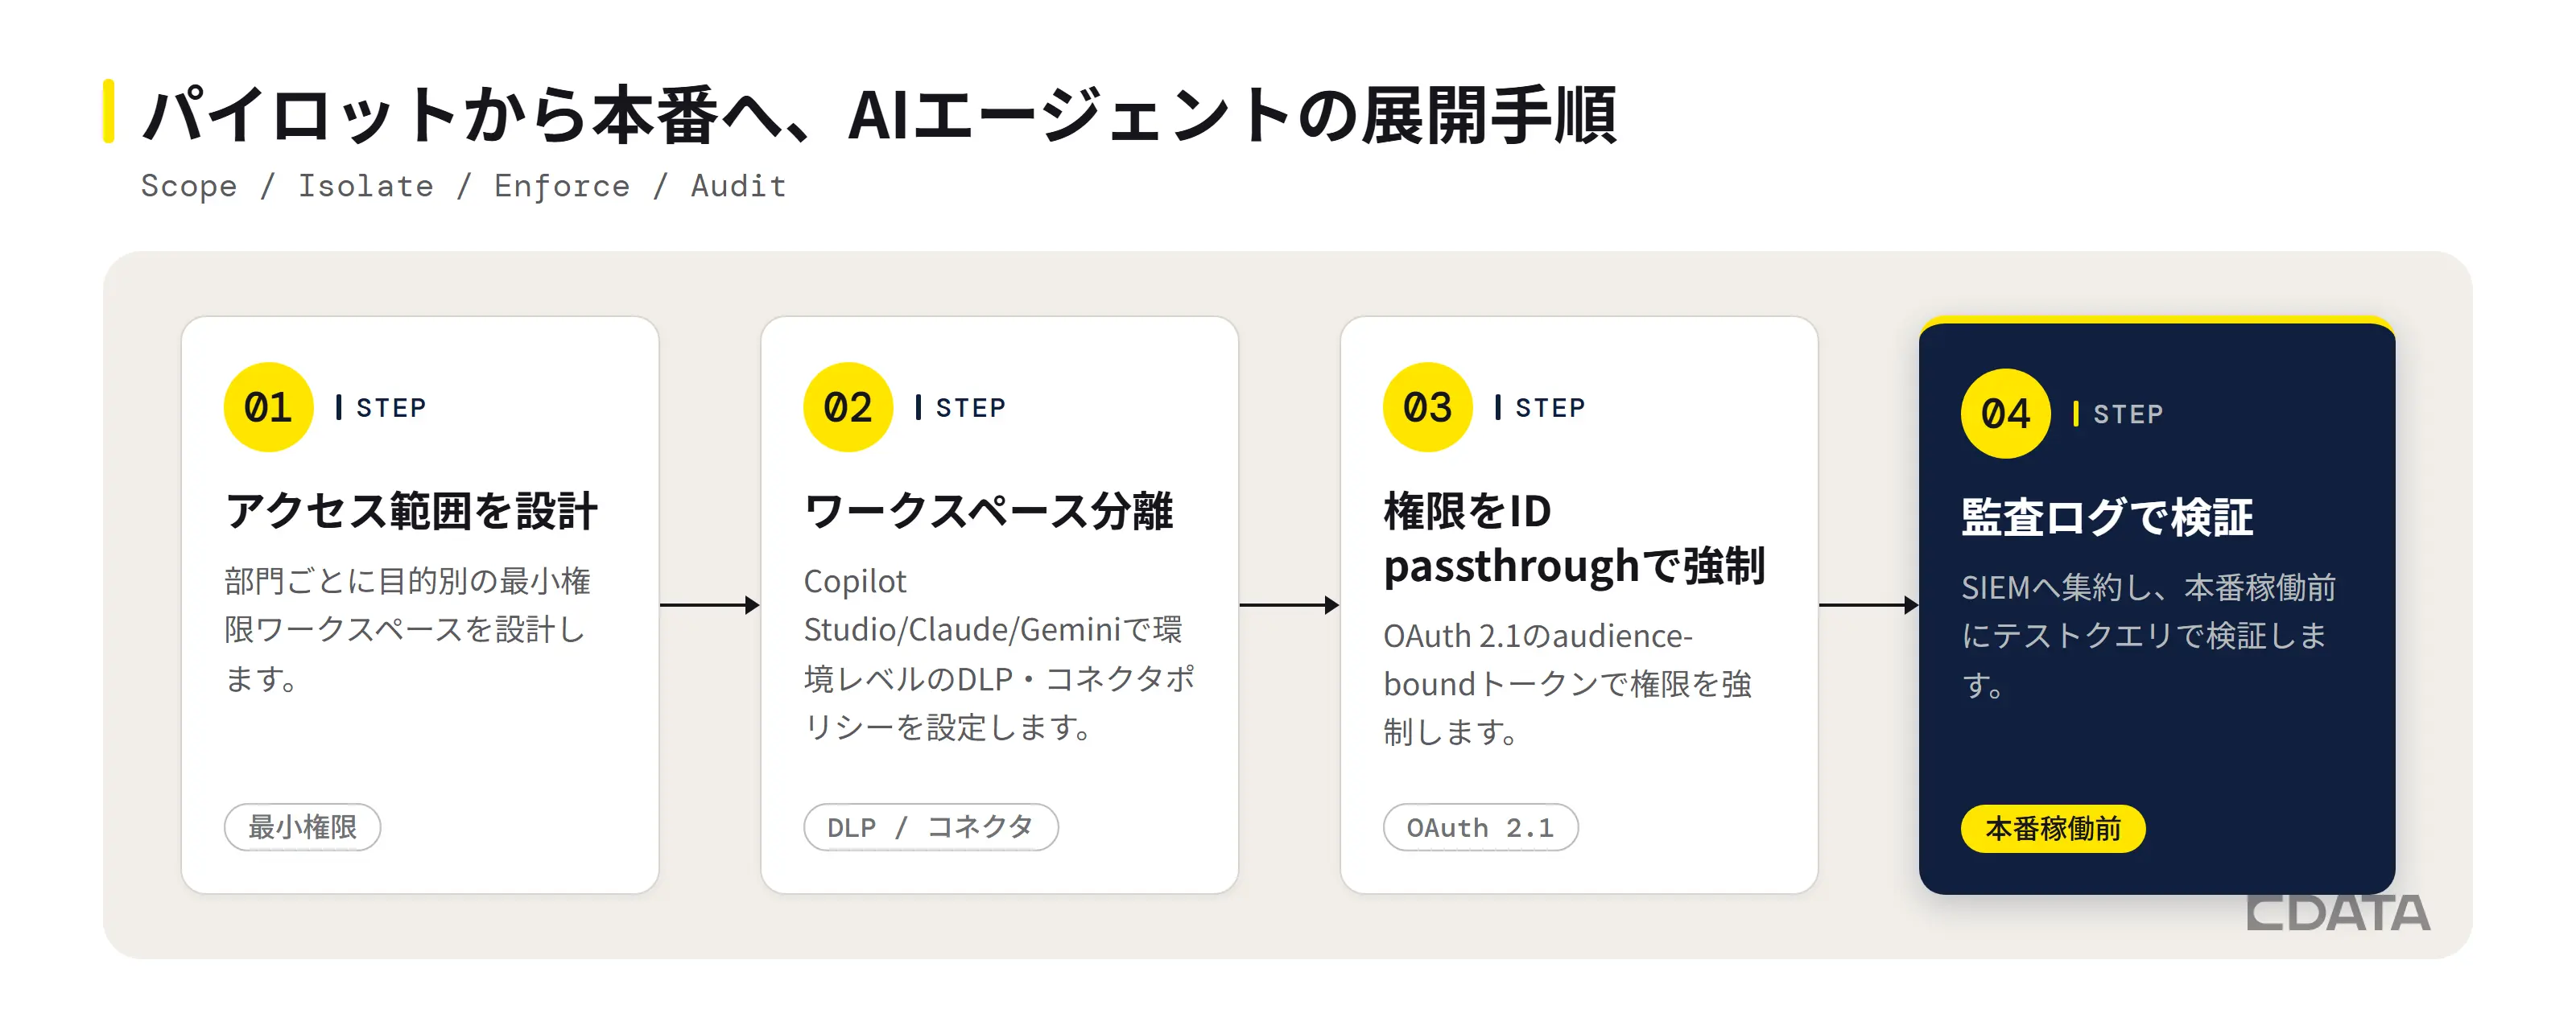
ステップ1:部門ごとにエージェントのデータアクセス範囲を決める
最小権限を設計段階から担保するために、目的別のワークスペースを作ります。財務AIには財務システムを、営業AIにはCRMを割り当て、互いのデータには届かないようにします。日本企業の場合、対象となるデータソースはSalesforceやSAPに限らず、kintoneやExcel台帳、基幹システムまで含むのが実情です。どのデータソースを、どの部門のエージェントに割り当てるかを、この段階で明確にしておきます。
ステップ2:Copilot Studio、Claude、Geminiでワークスペース分離を設定する
Copilot Studioでは、データ損失防止(DLP)ポリシーがエージェントの使えるコネクタとナレッジソースを制御し、環境レベルで適用されます。つまり同じエージェントでも、動く環境が変われば挙動が変わります。CDataはこの制御の下に接続レイヤーとして動作し、ポリシーが許容する統治済みのデータソースを提供します。Connect AIがGemini Enterpriseをリアルタイムデータに接続するのも同じ考え方です。
ステップ3:IDパススルーで権限を強制する
OAuth 2.1の認可を設定し、特定のMCPサーバーに対してエージェントのクエリがエンドユーザーの権限スコープのもとで実行されるようにします。この一手間によって、権限の所在はエージェントからそのユーザー本人へと移ります。エージェントはあくまで、そのユーザーの代理として動いているにすぎません。
ステップ4:監査ログを有効化し、本番稼働前に検証する
実行ログ・ツール呼び出しログ・ポリシー適用ログをSIEMに集約し、PoCを本番に昇格させる前に、すべてのクエリがユーザー帰属を伴っているかを確認します。権限を絞ったテストユーザーで試験クエリを実行し、そのユーザーが見てよい範囲のデータだけが返ることを確かめておきましょう。
ステップ | アクション | 設定する統制 | 本番稼働前の検証 |
1 | 部門ごとにアクセス範囲を決める | 目的別の最小権限ワークスペース | 財務エージェントがCRMデータに問い合わせできないことを確認する |
2 | 環境ごとに分離する | 環境レベルのDLP・コネクタポリシー | ブロックしたデータソースがその環境で実際に届かないことを確認する |
3 | IDパススルーを有効にする | OAuth/SAMLトークンのオーディエンス紐づけ | テストクエリがそのテストユーザーの権限範囲だけを返すことを確認する |
4 | 監査ログを有効にする | 実行ログとポリシーログをSIEMへ | すべてのクエリにユーザー帰属が付いていることを確認する |
コンプライアンス規格とのマッピング
2023年12月に発行されたISO/IEC 42001は初のAIマネジメントシステム規格で、AIマネジメントシステムを確立し改善するための要求事項を定めています。第三者監査で認証を取得できる点が重要で、調達部門がポリシーではなく証明を求めてきたときに意味を持ちます。EU AI Actはリスクの階層ごとに義務を構造化しており、高リスクシステムにはリスクマネジメントシステムを含む広範な要求が課され、提供者は所轄当局の求めに応じて適合性を証明できる状態を保つ必要があります。
NIST AI RMFは、「ガバナンス(Govern)」・「マップ(Map)」・「測定(Measure)」・「管理(Manage)」という任意かつ業種横断の手法であり続けており、ガバナンスのプロセスを技術的な統制に結びつけます。生成AIプロファイルはデータ漏えいのような生成AI固有のリスクを扱います。最小権限の原則はこれらすべてに明示・暗黙を問わず通底しており、だからこそ4本柱はどのフレームワークの監査にも耐えます。
ここは明確にしておく価値があります。ISO/IEC 42001は認証可能な規格ですが、NIST AI RMFやISO/IEC 23894のようなガイダンス文書は認証の対象ではありません。統制を証明する必要があるときは、どちらの規格が正式な認証を提供し、どちらが手法を提供しているだけなのかを区別してください。
ここまでは海外の規格ですが、日本企業の稟議・セキュリティ審査では、これに加えて国内の規制・ガイドラインへの対応も問われます。具体的には、個人情報保護法における個人データの取り扱い、経済産業省が示すAI事業者ガイドラインが求めるリスクベースの運用、金融機関であればFISC安全対策基準が定める安全管理措置です。
4本柱の統制――ID パススルー、RBAC、ワークスペース分離、監査証跡――は、いずれの規制でも「誰がどのデータに、どの権限でアクセスしたか」を後から示せることを土台にしているため、国内規制への対応もこの4本柱の延長線上で整理できます。金融・保険のように規制の網が特に厚い業種では、この対応関係を審査資料の中でより詳しく説明する場面が増えるでしょう。
統制 | SOC 2 | ISO/IEC 42001 | GDPR | EU AI Act |
IDパススルーとRBAC | 論理アクセス制御 | アクセス制御(附属書A) | 認可された目的に限定したアクセス | 高リスクシステムのアクセス制御 |
ワークスペース分離・最小権限 | アクセスの分離 | 運用管理策 | データ最小化 | リスクマネジメントシステム |
監査証跡・SIEM連携 | モニタリング基準 | パフォーマンス評価とログ記録 | 処理記録 | ログ記録とトレーサビリティ |
データソース側のガバナンス | データ分類 | AIシステムのデータ統制 | 適法根拠と目的制限 | データガバナンス義務 |
ガバナンスは「設定」ではなくインフラである
プラットフォームごとに個別設定するガバナンスは、新しいPoCが増えるたびにセキュリティ負債を積み増します。新しいエージェントのプラットフォームが増えるたびに連携を作り直し、権限を手作業で再適用し、審査もゼロからやり直すことになります。
中立的なインフラのレイヤーとして提供されるガバナンスは逆で、新しいプラットフォームが加わっても権限と監査を自動的に引き継ぎます。AIはいまやクラウド・SaaS・開発パイプライン・業務データを横断して同時に動いており、この状況はAIガバナンスをサイバーセキュリティと密接に結びつけており、ツールごとに個別対応する統制ではスケールしなくなっています。
観点 | 個別設定プロジェクト | インフラとしてのガバナンス |
新しいAIプラットフォームの追加 | 連携を作り直し権限を再適用する | 権限と監査ログが自動的に引き継がれる |
権限モデル | ツールごとに作り直され、時間とともにずれていく | 接続レイヤーで一度だけ強制され、どこでも継承される |
監査証跡 | 各プラットフォームのログにばらばらに存在する | クエリ単位の帰属情報を1つのSIEMに統一して出力 |
セキュリティ審査 | PoCのたびに最初からやり直す | 同じ承認済みの統制を使い回せる |
CData Connect AIは数百の業務データソースの中間にガバナンスレイヤーとして入り、OAuth/SAMLパススルーとユーザー単位の権限強制を提供するため、ここで紹介した4本の柱がCopilot Studio・Claude・ChatGPT Enterprise・Geminiを横断して同時に機能し続けます。各プラットフォームのネイティブな統制はそのまま活かした上で、その下で接続と権限強制を担うレイヤーとして機能します。
統治されたデータソースが1つ構築されていれば、新しいAIプラットフォームが加わっても権限と監査ログはそのまま引き継がれます。それこそが監査担当者や経営層が本当に求めている、繰り返し提示できるリスクマネジメントです。
実際に、AI SaaS・ノーコードプラットフォーム企業ではMCPベースの共通インターフェースを標準化したことで、エンタープライズ・レガシーシステムへのガバナンスに準拠したアクセスを一貫させながら、データ統合にかかる期間を数人月から1週間未満へと80%以上短縮できています。
よくあるガバナンス課題のトラブルシューティング
MCPはOAuth 2.1のベアラートークンに依存していますが、プロトコルレベルのライフサイクル管理までは義務付けていません。トークンの更新・失効・再利用の管理は実装側に委ねられているため、対処しなければセッションハイジャックやトークンの使い回しにつながりかねません。トークンの有効期限を短く保ち、ローテーションを管理することがその対処になります。
この種のリスクが実際にどう悪用されうるかは、MCPゲートウェイのセキュリティリスクを構造から解明したSmitheryインシデントの教訓が具体的な事例として参考になります。認可が特定のリソースに紐づいていない場合にも、似た抜け穴が生まれます。侵害されたツールが1つあれば、それがユーザーの気づかないところで機密データを読み取り、別の場所に書き出せてしまうため、リソースに厳密に紐づいたスコープの限定された権限が有効な対処です。
もう一つ厄介なのが、静かに起きる失敗です。Copilot Studioでは、DLPポリシーがナレッジソースをブロックするとエージェントは単に「何も返さない」だけで、エラーは表示されません。空の結果を「データが存在しない」と読み違えず、環境ごとにデータソースへのアクセスを検証してください。
権限の乱用や暴走エージェントはOWASPのagenticリストでも上位に位置づけられており、エージェントが何にアクセスし、どこにデータを送り、どのツールを呼び出したかを継続的に観察する行動監視が、その検知方法になります。
症状 | 想定される原因 | ガバナンス上の対処 |
ユーザーが見てはいけないデータをエージェントが返す | パススルーではなく共有サービスアカウントで認証している | OAuth/SAML IDのpassthroughに切り替え、クエリにエンドユーザーの権限を引き継がせる |
エージェントが黙って何も返さない | その環境でDLPポリシーがナレッジソースをブロックしている | 「データがない」と判断する前に、環境ごとにデータソースへのアクセスを検証する |
トークンが再利用されたりセッションが乗っ取られたりする | トークンのライフサイクル管理(更新・失効)がない | 有効期限を短くし、ローテーションを管理する |
エージェントが無関係なツールやデータに届いてしまう | 認可が特定のリソースに紐づいていない | リソースに厳密に紐づいたスコープの限定された権限を適用し、行動を監視する |
CDataでAIエージェントの導入にガバナンスを
ITにとっての成果は、セキュリティ負債を抱え込むことなくエージェントのPoCに「イエス」と言える監査対応可能なロードマップを策定することです。ここまで見てきた4本柱は、Connect AIならOAuth/SAML パススルー、ユーザー単位の権限、ワークスペース分離、SIEMへ書き出せるログとして数百のデータソースを横断して同時に強制できます。
ここまで見てきたSOC 2・ISO/IEC 42001・GDPR・EU AI Actへの対応も、この統制の上に成り立っています。セキュリティチームが承認しやすい姿勢は、エージェントがタスクに必要な最小限のアクセスしか持たない状態が、接続レイヤーで強制されていることです。エージェントのPoCの統治レイヤーとしてConnect AIを評価するには、CData Connect AIを見るところから、スコープを絞ったトライアルで始めてみてください。
無料トライアルを始める
よくある質問
従来のデータガバナンスとAIエージェントのデータガバナンスはどう違いますか?
違いは「行動」にあります。従来のデータガバナンスは、誰がデータを読めるか、データがどう移動するかを統制します。AIエージェントのデータガバナンスはそれだけでは足りません。エージェントはツールを呼び出し、複数のステップを連結させ、1回のリクエストの中で本番システムに書き込むことさえあるからです。したがってガバナンスは実行時の自律的な振る舞いを統制し、あらゆる行動を実在するIDに紐づける必要があります。これはデータソース側のアクセス制御だけでは果たせなかった役割です。
AIエージェントを業務データに接続する前に、IT部門は何を用意しておくべきですか?
接続前に、データソース側で5つのことを定義しておきます。名前の付いたデータ所有者、機密度の分類、データの系統、アクセスポリシー、保持ポリシーです。AIによる検索・取得はデータソース側の権限をそのまま引き継ぐため、RBACはまずデータソース側で正しく設定されていなければなりません。先につないでから統治するという順番が、本番承認を止める典型的な誤りです。日本企業の場合、これらの承認は単一のレビューボードではなく複数階層の稟議を経て確定するのが一般的です。
AIエージェントのデータガバナンスに、最小権限のアクセス制御をどう適用しますか?
各エージェントには、そのタスクに必要な最小限のアクセスだけを与え、それをワークスペース分離によって構造的に強制します。財務エージェントは財務システムだけに、営業エージェントはCRMだけに届く、という具合です。ID パススルーと組み合わせることで、クエリはエンドユーザーのロールのもとで実行されるため、最小権限は設計によって1エージェントあたりの影響範囲を区切ります。
コンプライアンスのために、AIエージェントの監査証跡には何を記録すべきですか?
何がその行動を引き起こしたか、エージェントがどのデータを使ったか、何を実行したか、その結果はどうだったかを、エージェントに指示を出した個人ごとに記録します。実行イベント、ツール呼び出し、ポリシー適用の判定をSIEMに送り、データの経路全体をいつでも再構成できるようにします。監査担当者がまず求めるのは、クエリ単位でのユーザー帰属です。
SalesforceやSAPのようなシステムにAIエージェントがアクセスするとき、認証情報のセキュリティはどう扱うべきですか?
共有のサービスアカウントは避けてください。OAuthまたはSAML IDのpassthroughを使い、エージェントがエンドユーザーとして認証し、そのユーザーがSalesforce・SAP・その他のデータソースですでに持っている権限をそのまま引き継ぐようにします。トークンは特定のリソースに紐づけ、有効期限を短く保ち、ローテーションを管理することで、1つの認証情報だけであらゆる場所に静かに到達できてしまう事態を防ぎます。
個人情報保護法やFISC安全対策基準など、日本固有の規制にはどう対応すればよいですか?
ID パススルー・RBAC・ワークスペース分離・監査証跡という4本柱は、「誰がどのデータに、どの権限でアクセスしたか」を後から示せることを土台にしており、これは個人情報保護法が求める個人データの適切な取り扱いや、金融機関に課されるFISC安全対策基準の安全管理措置とも矛盾しません。経済産業省のAI事業者ガイドラインが求めるリスクベースの運用も、同じ4本柱の記録と権限設計の上に構築できます。国内規制への対応を審査資料にまとめる際は、この4本柱をそのままチェックリストとして使うと整理しやすくなります。
あらゆるデータソースへのAI接続にガバナンスを
本記事で見た4本柱は、kintoneやExcel、Salesforceなど数百のデータソースを横断してConnect AIが一括で強制します。まずはスコープを絞ったトライアルから始めてみてください。


